생성형 AI가 등장한 이후 우리는 AI에게 질문하고, AI가 만들어낸 답변을 사람이 확인하는 방식에 익숙해졌습니다. 하지만 최근 AI의 역할은 답변을 생성하는 것을 넘어 상황을 판단하고 다음 행동을 결정하는 영역으로 확장되고 있습니다.
2026년 9월 공개된 TypeSafe AI의 Jev가 대표적인 사례입니다. Jev는 일반적인 LLM처럼 문장을 생성하는 대신, 주어진 정보를 평가해 선택, 점수, 확률과 같은 구조화된 판단을 반환하는 Decision Model입니다.
예를 들어 고객 문의를 어느 부서로 전달할지, 특정 요청의 위험도가 얼마나 높은지, AI Agent가 다음 단계에서 어떤 Tool을 사용할지처럼 소프트웨어의 다음 행동을 결정하는 과정에 활용할 수 있습니다. AI가 답변을 만드는 것을 넘어 소프트웨어의 판단 과정에 직접 참여하기 시작한 것입니다.
그렇다면 AI의 판단이 실제 시스템의 행동으로 이어질 때, 기업은 그 과정을 어디까지 신뢰하고 어떻게 통제해야 할까요?
문장을 생성하는 LLM에서, 판단을 내리는 Decision Model로
ChatGPT나 Claude와 같은 LLM은 사용자의 입력을 바탕으로 자연어를 생성합니다. 사람이 질문하면 AI가 답변을 만들고, 그 결과를 사람이 읽은 뒤 다음 행동을 결정하는 방식입니다.
Jev는 목적이 조금 다릅니다. 현재 상황이나 데이터를 State로 전달하고 필요한 판단을 Question으로 정의하면, Jev가 정해진 형태의 결과와 확률을 반환합니다.
고객 문의를 예로 들면 긴 답변을 생성하는 대신 ‘어떤 유형의 문의인지’, ‘우선순위는 어느 정도인지’, ‘사람의 검토가 필요한지’를 판단해 애플리케이션이 바로 활용할 수 있는 결과를 제공하는 식입니다.
State → Question → Decision → Action
모든 AI 작업에 긴 자연어 생성이나 복잡한 추론이 필요한 것은 아닙니다. AI Agent가 다음에 사용할 Tool을 고르거나 요청의 위험도를 Low·Medium·High로 분류하는 작업이라면, 자연어를 생성한 뒤 다시 프로그램이 의미를 해석하는 것보다 처음부터 구조화된 판단을 받는 방식이 효율적일 수 있습니다.
이 때문에 Jev와 같은 Decision Model은 Routing, Classification, Risk Scoring, Filtering, AI Agent의 Tool 선택처럼 명확한 판단이 반복되는 영역에서 활용 가능성이 주목받고 있습니다. AI의 역할이 Generation에서 Decision으로, 그리고 Action에 가까워지고 있습니다.
AI의 판단이 곧 시스템의 행동이 된다면?
Decision Model의 등장에서 주목해야 할 것은 새로운 AI 모델 하나가 추가됐다는 사실만이 아닙니다. AI의 결과가 실제 시스템의 행동과 더 가까워지고 있다는 점입니다.
기존 생성형 AI에서는 일반적으로 사용자 → AI → 답변 → 사람의 확인 → 행동이라는 흐름이 만들어집니다. AI가 잘못된 답변을 생성하더라도 사람이 결과를 검토하고 최종 행동을 결정할 수 있는 단계가 존재합니다.
하지만 AI의 판단 결과를 애플리케이션이나 AI Agent가 직접 활용하면 AI의 판단에 따라 고객 문의가 자동으로 다른 Workflow로 전달되거나, 특정 요청이 Human Review 대상으로 분류되고, AI Agent가 다음에 사용할 Tool이 선택될 수 있습니다.
여기서 중요한 원칙은 AI의 판단과 시스템의 권한은 같지 않다는 점입니다. AI가 특정 행동을 선택했다고 해서 실제 실행까지 자동으로 허용할 필요는 없습니다. 실제 Tool 실행이나 API 호출 전에는 별도의 권한 확인과 정책 검증, 입력값 검증 등의 통제 단계가 필요합니다.
이는 Jev처럼 결과가 구조화된 모델에서도 마찬가지입니다. 최근 Check Point Research가 Jev를 대상으로 진행한 초기 보안 실험에서는 외부 입력에 포함된 조작된 정보를 통해 모델의 판단 결과가 달라질 수 있음을 확인했습니다. 구조화된 입력과 출력이 애플리케이션 연동에는 유리하지만, 그 자체가 판단의 안전성을 보장하는 보안 장치는 아니라는 것입니다.
따라서 앞으로는 ‘AI가 올바른 형식으로 답했는가?’뿐 아니라 ‘AI가 무엇을 근거로 판단했고, 그 판단이 어디까지 실행될 수 있는가?’까지 함께 살펴봐야 합니다.
Decision AI 시대, 기업이 고려해야 할 4가지 보안 과제
1) AI는 무엇을 보고 판단하는가 — Input & Context Security
AI의 판단은 입력된 Context를 기반으로 이루어집니다. 여기에는 사용자의 질문뿐 아니라 사내 문서, 소스코드, API 조회 결과, 고객정보와 같은 다양한 업무 데이터가 포함될 수 있습니다.
문제는 AI에 전달되는 정보가 항상 안전하고 신뢰할 수 있는 것은 아니라는 점입니다. 외부에서 유입된 데이터가 AI의 판단을 왜곡할 수도 있고, 반대로 AI가 판단에 필요하지 않은 개인정보나 인증정보, 기업 기밀까지 전달받을 수도 있습니다.
따라서 기업은 AI가 어떤 정보를 활용하는지 파악하고, 민감정보와 신뢰할 수 없는 입력을 AI 호출 전후에서 식별하고 통제할 수 있어야 합니다.
2) AI에게 무엇을 판단하도록 허용할 것인가 — AI Policy
AI를 활용한다고 해서 모든 판단을 AI에 맡겨야 하는 것은 아닙니다. 반복적이고 위험도가 낮은 업무는 자동화하더라도 중요한 의사결정이나 일정 수준 이상의 위험이 있는 작업은 사람의 검토를 거치도록 설계할 수 있습니다.
예를 들어 판단의 신뢰도가 충분히 높다면 다음 단계로 진행하고, 불확실성이 높거나 특정 조건에 해당하면 Human Review로 전환하는 방식입니다.
중요한 것은 개별 모델의 성능만 신뢰하는 것이 아니라 AI가 판단할 수 있는 범위와 사람이 개입해야 하는 경계를 기업의 정책으로 정의하는 것입니다.
3) AI의 판단을 어디까지 실행할 것인가 — Decision & Action Control
AI Agent 환경에서는 AI의 판단 결과가 Tool이나 API 실행으로 이어질 수 있기 때문에 판단과 실행 사이의 통제가 더욱 중요합니다.
AI가 특정 Tool 사용을 선택했더라도 실제 실행 전에는 해당 Agent에게 권한이 있는지, 요청된 작업이 기업 정책에 부합하는지, 전달되는 값에 문제가 없는지 등을 별도로 확인해야 합니다.
즉, AI Decision → Policy Check → Permission → Action의 구조가 필요합니다. AI가 무엇을 할지 판단할 수는 있지만, 실제 시스템의 권한과 실행 정책까지 AI의 판단만으로 결정하게 하는 것은 별개의 문제입니다.
4) AI가 어떤 판단을 내렸는지 추적할 수 있는가 — Logging & Audit
AI가 업무 프로세스에 깊게 들어갈수록 어떤 데이터가 전달됐고, 어떤 모델이 어떤 판단을 내렸으며, 그 결과가 어떤 행동으로 이어졌는지까지 확인할 수 있어야 합니다.
특히 하나의 Workflow에 LLM, AI Agent, Decision Model과 여러 Tool이 함께 참여한다면 각각의 호출과 로그가 여러 시스템에 흩어질 수 있습니다. 문제가 발생했을 때 전체 과정을 재구성하기 어려워지는 이유입니다.
따라서 AI Governance 역시 단순한 AI 사용 여부 관리에서 데이터 → 판단 → 행동으로 이어지는 전체 과정을 추적하는 방향으로 확장될 필요가 있습니다.
다양한 AI를 하나의 정책 아래 관리하려면
기업이 사용하는 AI는 이미 하나의 모델에 머물지 않습니다. 문서 작성과 분석에는 LLM을 사용하고, 개발 업무에는 Coding Agent를 활용하며, 특정 업무에는 사내 모델이나 전문 AI를 연결할 수 있습니다. 여기에 Jev와 같은 Decision Model까지 등장하면서 기업의 AI 환경은 더욱 다양해지고 있습니다.
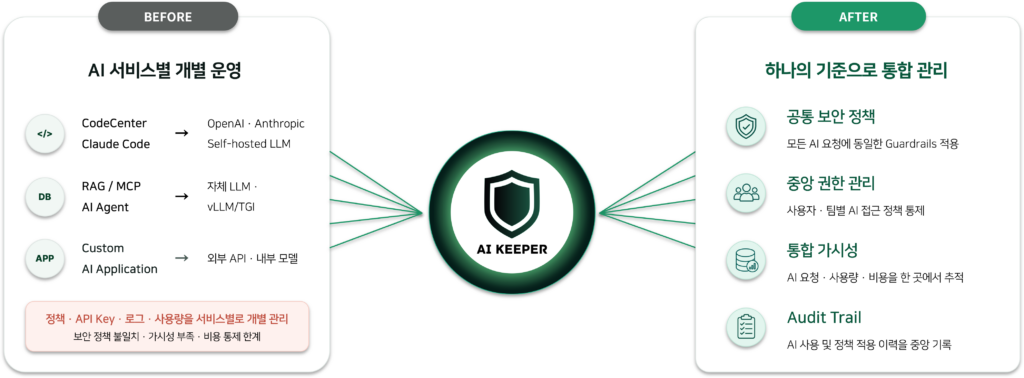
문제는 모델과 서비스마다 별도의 보안 정책과 로그 체계를 운영하면 AI가 늘어날수록 관리 지점 역시 함께 늘어난다는 것입니다. 어떤 AI에 어떤 정보가 전달되는지, 기업의 보안 정책이 동일하게 적용되는지, 사용 과정에서 문제가 발생했을 때 이를 추적할 수 있는지 확인하기도 어려워집니다.
따라서 개별 AI 모델의 보안 기능만큼 중요해지는 것이 여러 AI와 기업 시스템 사이에서 데이터 흐름과 사용 정책을 일관되게 관리하는 공통 Governance Layer입니다.
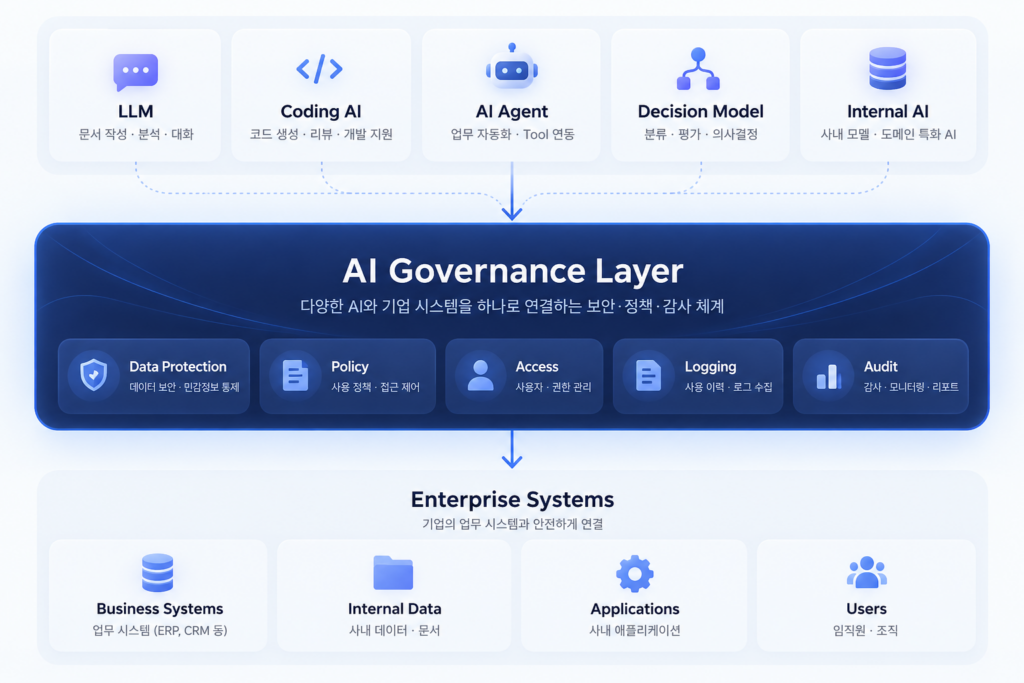
AI Keeper, AI와 기업 시스템 사이의 Governance Layer
AI Keeper는 기업에서 사용하는 여러 LLM과 AI 서비스의 연결을 하나의 Self-Hosted Gateway로 통합하고, AI와 오가는 정보에 보안·정책·감사 체계를 일관되게 적용할 수 있도록 지원하는 AI Governance 플랫폼입니다.
기업에서 여러 AI를 사용하더라도 연결 지점을 공통된 경로에서 관리하면 서비스마다 분산되기 쉬운 데이터 보호 정책과 사용 이력을 보다 일관되게 관리할 수 있습니다.
특히 AI의 역할이 단순한 답변 생성에서 판단과 업무 자동화로 확대될수록 어떤 AI가 사용되고 있는지, 어떤 정보가 AI로 전달되는지, 기업의 AI 사용 정책이 제대로 적용되고 있는지, 사용 과정에서 어떤 일이 발생했는지를 파악하는 것이 중요해집니다.
AI Keeper의 역할도 특정 AI 모델의 사용을 막는 데 있지 않습니다. 기업이 업무 목적에 따라 다양한 AI를 활용하면서도 AI와 기업 시스템 사이의 데이터 흐름과 연결을 기업의 보안 정책 안에서 관리할 수 있는 환경을 만드는 것에 가깝습니다.
생성에서 판단으로, AI 보안의 범위도 달라지고 있습니다
생성형 AI는 AI가 무엇을 만드는가에 대한 질문을 던졌고, AI Agent의 확산은 AI가 무엇을 할 수 있는가에 대한 고민을 만들었습니다. 이제 Jev와 같은 Decision Model의 등장은 AI에게 무엇을 판단하도록 맡길 것인가라는 새로운 질문을 던지고 있습니다.
AI의 역할이 Generation → Decision → Action으로 확대될수록 기업 AI 보안 역시 모델 하나의 안전성만으로 해결하기 어려워집니다. AI에 어떤 정보가 전달되는지, 어떤 판단을 맡길 것인지, 그 판단을 어디까지 실행하도록 허용할 것인지, 그리고 전체 과정을 추적할 수 있는지를 함께 관리해야 합니다.
결국 중요한 것은 AI를 제한하는 것이 아니라 AI가 더 많은 업무에 참여하더라도 기업이 그 범위와 흐름을 통제할 수 있는 환경을 만드는 것입니다. AI의 역할이 달라지고 있다면, AI를 관리하는 방식도 함께 달라져야 합니다.
Jev와 Decision AI, 이것이 궁금합니다
Jev란 무엇인가요?
Jev는 TypeSafe AI가 공개한 System One Model로, 일반적인 LLM처럼 긴 자연어를 생성하기보다 소프트웨어가 활용할 수 있는 선택, 점수, 확률 등의 구조화된 판단을 반환하도록 설계된 AI 모델입니다.
Jev와 LLM은 무엇이 다른가요?
LLM은 텍스트 생성, 대화, 분석 등 폭넓은 작업에 활용되는 반면 Jev는 분류, 평가, Routing처럼 범위가 명확한 판단을 빠르게 수행하는 데 초점을 둡니다. 두 방식은 대체 관계라기보다 하나의 AI Workflow 안에서 서로 다른 역할을 담당할 수 있습니다.
구조화된 판단을 사용하는 Decision Model은 더 안전한가요?
구조화된 출력은 애플리케이션에서 결과를 활용하기 쉽게 만들지만 그 자체가 보안을 보장하지는 않습니다. AI가 어떤 데이터를 근거로 판단하는지, 판단 결과에 어떤 권한을 부여할지, 실제 실행 전에 어떤 정책을 적용할지 등을 별도로 관리해야 합니다.
기업에서 AI Governance가 필요한 이유는 무엇인가요?
기업이 LLM, AI Agent, 전문 AI 등 여러 모델을 함께 사용하면 데이터와 정책, 로그가 여러 서비스로 분산될 수 있습니다. AI Governance는 다양한 AI의 데이터 흐름과 사용 정책, 이력을 일관된 기준으로 관리하고 추적하기 위한 체계입니다.